本轮要点: 作用域链与闭包、全方位解读this、函数柯里化、原型链与继承、DOM操作、深拷贝/浅拷贝、call、apply和bind
本轮共 24 道题。答案默认折叠,便于先自行作答。
1. 深拷贝浅拷贝有什么区别?怎么实现深拷贝?
题库原题:深拷贝浅拷贝有什么区别?怎么实现深拷贝?
题目要点
JS数据类型分别基本数据类型和引用数据类型,基本数据类型保存的是值,引用类型保存的是引用地址(this指针)。
浅拷贝共用一个引用地址,深拷贝会创建新的内存地址。
浅拷贝方法
- 直接对象复制
- Object.assign
深拷贝
- JSON.stringify转为字符串再JSON.parse
- 深度递归遍历
参考答案
一、数据类型存储
前面文章我们讲到,JavaScript中存在两大数据类型:
- 基本类型
- 引用类型
基本类型数据保存在在栈内存中
引用类型数据保存在堆内存中,引用数据类型的变量是一个指向堆内存中实际对象的引用,存在栈中
二、浅拷贝
浅拷贝,指的是创建新的数据,这个数据有着原始数据属性值的一份精确拷贝
如果属性是基本类型,拷贝的就是基本类型的值。如果属性是引用类型,拷贝的就是内存地址
即浅拷贝是拷贝一层,深层次的引用类型则共享内存地址
下面简单实现一个浅拷贝
function shallowClone(obj) {
    const newObj = {};
    for(let prop in obj) {
        if(obj.hasOwnProperty(prop)){
            newObj[prop] = obj[prop];
        }
    }
    return newObj;
}
在JavaScript中,存在浅拷贝的现象有:
Object.assignArray.prototype.slice(),Array.prototype.concat()- 使用拓展运算符实现的复制
Object.assign
var obj = {
    age: 18,
    nature: ['smart', 'good'],
    names: {
        name1: 'fx',
        name2: 'xka'
    },
    love: function () {
        console.log('fx is a great girl')
    }
}
var newObj = Object.assign({}, obj);
slice()
const fxArr = ["One", "Two", "Three"]
const fxArrs = fxArr.slice(0)
fxArrs[1] = "love";
console.log(fxArr) // ["One", "Two", "Three"]
console.log(fxArrs) // ["One", "love", "Three"]
concat()
const fxArr = ["One", "Two", "Three"]
const fxArrs = fxArr.concat()
fxArrs[1] = "love";
console.log(fxArr) // ["One", "Two", "Three"]
console.log(fxArrs) // ["One", "love", "Three"]
拓展运算符
const fxArr = ["One", "Two", "Three"]
const fxArrs = [...fxArr]
fxArrs[1] = "love";
console.log(fxArr) // ["One", "Two", "Three"]
console.log(fxArrs) // ["One", "love", "Three"]
三、深拷贝
深拷贝开辟一个新的栈,两个对象的属性完全相同,但是对应两个不同的地址,修改一个对象的属性,不会改变另一个对象的属性
常见的深拷贝方式有:
_.cloneDeep()
jQuery.extend()
JSON.stringify()
手写循环递归
_.cloneDeep()
const _ = require('lodash');
const obj1 = {
    a: 1,
    b: { f: { g: 1 } },
    c: [1, 2, 3]
};
const obj2 = _.cloneDeep(obj1);
console.log(obj1.b.f === obj2.b.f);// false
jQuery.extend()
const $ = require('jquery');
const obj1 = {
    a: 1,
    b: { f: { g: 1 } },
    c: [1, 2, 3]
};
const obj2 = $.extend(true, {}, obj1);
console.log(obj1.b.f === obj2.b.f); // false
JSON.stringify()
const obj2=JSON.parse(JSON.stringify(obj1));
但是这种方式存在弊端,会忽略undefined、symbol和函数
const obj = {
    name: 'A',
    name1: undefined,
    name3: function() {},
    name4:  Symbol('A')
}
const obj2 = JSON.parse(JSON.stringify(obj));
console.log(obj2); // {name: "A"}
循环递归
function deepClone(obj, hash = new WeakMap()) {
  if (obj === null) return obj; // 如果是null或者undefined我就不进行拷贝操作
  if (obj instanceof Date) return new Date(obj);
  if (obj instanceof RegExp) return new RegExp(obj);
  // 可能是对象或者普通的值  如果是函数的话是不需要深拷贝
  if (typeof obj !== "object") return obj;
  // 是对象的话就要进行深拷贝
  if (hash.get(obj)) return hash.get(obj);
  let cloneObj = new obj.constructor();
  // 找到的是所属类原型上的constructor,而原型上的 constructor指向的是当前类本身
  hash.set(obj, cloneObj);
  for (let key in obj) {
    if (obj.hasOwnProperty(key)) {
      // 实现一个递归拷贝
      cloneObj[key] = deepClone(obj[key], hash);
    }
  }
  return cloneObj;
}
四、区别
下面首先借助两张图,可以更加清晰看到浅拷贝与深拷贝的区别
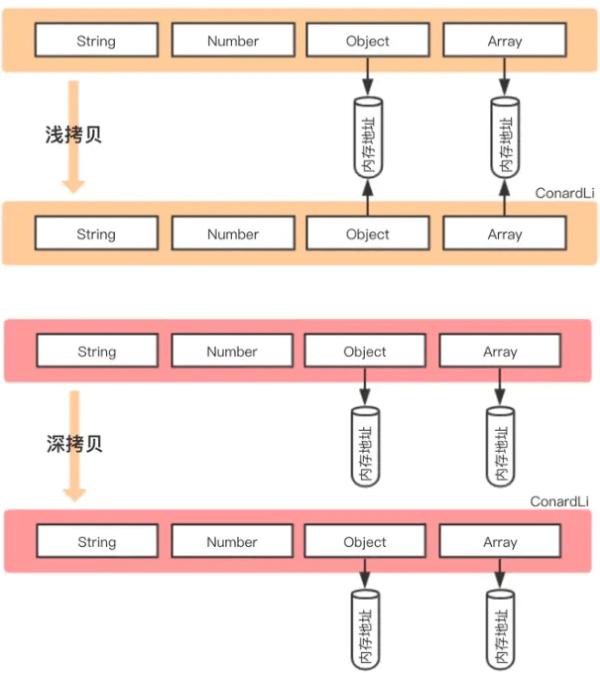
从上图发现,浅拷贝和深拷贝都创建出一个新的对象,但在复制对象属性的时候,行为就不一样
浅拷贝只复制属性指向某个对象的指针,而不复制对象本身,新旧对象还是共享同一块内存,修改对象属性会影响原对象
// 浅拷贝
const obj1 = {
    name : 'init',
    arr : [1,[2,3],4],
};
const obj3=shallowClone(obj1) // 一个浅拷贝方法
obj3.name = "update";
obj3.arr[1] = [5,6,7] ; // 新旧对象还是共享同一块内存

console.log('obj1',obj1) // obj1 { name: 'init',  arr: [ 1, [ 5, 6, 7 ], 4 ] }
console.log('obj3',obj3) // obj3 { name: 'update', arr: [ 1, [ 5, 6, 7 ], 4 ] }
但深拷贝会另外创造一个一模一样的对象,新对象跟原对象不共享内存,修改新对象不会改到原对象
// 深拷贝
const obj1 = {
    name : 'init',
    arr : [1,[2,3],4],
};
const obj4=deepClone(obj1) // 一个深拷贝方法
obj4.name = "update";
obj4.arr[1] = [5,6,7] ; // 新对象跟原对象不共享内存

console.log('obj1',obj1) // obj1 { name: 'init', arr: [ 1, [ 2, 3 ], 4 ] }
console.log('obj4',obj4) // obj4 { name: 'update', arr: [ 1, [ 5, 6, 7 ], 4 ] }
小结
前提为拷贝类型为引用类型的情况下:
- 浅拷贝是复制内存中的地址,拷贝前后的对象,因为引用类型共享了同一块内存,修改会相互影响。
- 深拷贝是递归拷贝深层次,属性为对象时,深拷贝是新开栈,两个对象指向不同的地址
2. 实现一个深拷贝函数,要求能够处理循环引用
题目要点
- 使用
typeof判断基本类型,直接返回 - 引用类型递归处理,创建新对象/数组
- 使用
WeakMap缓存已处理对象,解决循环引用问题 - 特殊对象如 Date、RegExp 要单独判断并处理
- 注意保留原型链、避免
null和undefined误处理
参考答案
考察点
- 对 JavaScript 基本类型、引用类型的理解
- 掌握递归深拷贝的基本原理与限制
- 解决复杂对象的循环引用问题(如对象相互嵌套)
- 使用
Map或WeakMap实现拷贝过程中的对象映射记录
参考答案
一、原理说明
普通的深拷贝通常通过递归实现:
- 如果值是原始类型(string、number、boolean、null、undefined、symbol、bigint),直接返回
- 如果是引用类型(Object、Array、Function、Date、RegExp等),需递归拷贝每一层属性
但是,当对象存在循环引用(例如 A -> B -> A)时,普通递归会导致死循环或栈溢出。
为了解决这一问题,可以使用 WeakMap(或 Map)记录已经拷贝过的对象,在遇到重复对象时直接返回缓存值,避免重复拷贝。
二、核心实现代码(支持循环引用)
function deepClone(obj, hash = new WeakMap()) {
  // 原始类型直接返回
  if (obj === null || typeof obj !== 'object') {
    return obj;
  }

  // 处理循环引用
  if (hash.has(obj)) {
    return hash.get(obj);
  }

  // 特殊对象处理
  if (obj instanceof Date) return new Date(obj);
  if (obj instanceof RegExp) return new RegExp(obj);

  // 初始化克隆结果
  const clone = Array.isArray(obj) ? [] : {};

  // 缓存当前对象
  hash.set(obj, clone);

  // 遍历对象自身属性(可加 Object.getOwnPropertyDescriptors 处理属性描述符)
  for (const key in obj) {
    if (obj.hasOwnProperty(key)) {
      clone[key] = deepClone(obj[key], hash);
    }
  }

  return clone;
}
三、示例测试
const a = { name: 'Alice' };
const b = { friend: a };
a.friend = b;

const clone = deepClone(a);
console.log(clone.friend.friend === clone); // true
四、注意事项与常见误区
不能直接用
JSON.parse(JSON.stringify(obj):- 会丢失函数、
undefined、Symbol、循环引用等
- 会丢失函数、
递归拷贝时要判断是否为对象,不能对
null递归循环引用时如果没有缓存机制会导致死循环
WeakMap相比Map更适合缓存对象引用,避免内存泄漏还可以扩展支持:Map、Set、Function、Symbol 等更复杂场景
3. 如何实现一个对象继承另一个对象的功能
题目要点
- 掌握
Object.create的使用方式,适合简单继承 - 了解构造函数与原型链继承的优缺点
- 推荐使用寄生组合继承或 ES6 class 实现完整继承
- 理解继承的本质是原型链指向关系
- 注意原型共享导致的数据污染问题
参考答案
考察点
- JS 原型继承机制及其本质理解
- 不同继承方式的优缺点(
Object.create、构造函数、class) - ES5 与 ES6 的继承语法及底层逻辑
- 原型链与原型对象(
__proto__和prototype)的概念辨析
参考答案
一、原理说明
JavaScript 是基于**原型链(Prototype Chain)**实现继承的,所有对象都可以通过其原型访问父对象的属性。
实现继承的几种方式:
1. 使用 Object.create(推荐方式)
const parent = { name: 'Parent' };
const child = Object.create(parent);
child.age = 10;
console.log(child.name); // 'Parent'
Object.create(proto)返回一个以proto为原型的新对象。- 不会拷贝属性,而是共享原型,适合简单对象继承。
2. 构造函数继承(伪类继承)
function Parent() {
  this.name = 'Parent';
}
function Child() {
  Parent.call(this); // 继承属性
  this.age = 10;
}
const child = new Child();
console.log(child.name); // 'Parent'
- 只能继承构造函数中的属性,无法继承原型上的方法。
3. 原型链继承(经典)
function Parent() {
  this.name = 'Parent';
}
Parent.prototype.sayHello = function() {
  console.log('Hello');
};
function Child() {}
Child.prototype = new Parent();
const child = new Child();
child.sayHello(); // Hello
- 缺点:引用类型会被所有实例共享。
4. 组合继承(构造 + 原型)
function Parent(name) {
  this.name = name;
}
Parent.prototype.sayHi = function() {
  console.log('Hi, ' + this.name);
};
function Child(name, age) {
  Parent.call(this, name); // 第一次调用
  this.age = age;
}
Child.prototype = new Parent(); // 第二次调用
Child.prototype.constructor = Child;
- 实现了属性和方法的继承,但调用了两次构造函数,存在性能浪费。
5. 寄生组合继承(最佳实践)
function Parent(name) {
  this.name = name;
}
Parent.prototype.sayHi = function() {
  console.log('Hi');
};

function Child(name, age) {
  Parent.call(this, name);
  this.age = age;
}

// 只继承原型,不调用构造函数
Child.prototype = Object.create(Parent.prototype);
Child.prototype.constructor = Child;
- 优点:避免了两次构造函数调用,继承了属性和方法,推荐使用。
6. ES6 class extends
class Parent {
  constructor(name) {
    this.name = name;
  }
  greet() {
    console.log('Hello');
  }
}
class Child extends Parent {
  constructor(name, age) {
    super(name);
    this.age = age;
  }
}
- 语法糖,本质仍是基于原型链的继承。
super()必须在constructor里第一个调用。
二、常见误区与陷阱
混淆
__proto__和prototype:obj.__proto__是对象实例的原型指针;Func.prototype是函数构造器的原型对象。
对象的继承不是拷贝,而是引用或链式访问
原型链继承中,所有实例共享引用类型属性,可能产生副作用
忘记设置
constructor会导致类型判断异常
4. 请实现一个柯里化函数,例如将一个加法函数 add(a, b, c) 转换为可以逐步传参的形式
题目要点
- 理解柯里化的本质是逐步收集参数,延迟执行
- 掌握闭包在参数持久化上的作用
- 能正确使用函数的
.length属性判断参数是否收集完毕 - 支持
f(1)(2)(3)/f(1, 2)(3)/f(1)(2, 3)等多种调用形式 - 熟悉通用柯里化函数的编写方式
- 了解柯里化在日常项目中的应用场景,如函数复用、偏函数应用等
参考答案
考察点
- 面试官出这道题主要是考察候选人对 JavaScript 函数柯里化的理解及实现能力
- 高频实际应用场景包括:函数组合、参数复用、偏函数等
- 涉及的知识点包括:闭包、函数参数、函数 length 属性、函数链式调用等
参考答案
一、原理说明
柯里化(Currying):是将一个接收多个参数的函数,转换成一系列接收单一参数的函数,并在最后返回结果的技术。
举例:
function add(a, b, c) => a + b + c转换为柯里化形式:
add(1)(2)(3)
柯里化的实现依赖闭包 —— 每次调用返回一个新函数并保存之前的参数,直到收集的参数数量达到原始函数的 length,才执行原函数。
二、核心用法 + 示例代码
实现通用 curry 函数:
function curry(fn) {
  return function curried(...args) {
    if (args.length >= fn.length) {
      return fn(...args);
    } else {
      return function (...nextArgs) {
        return curried(...args, ...nextArgs);
      };
    }
  };
}
使用示例:
function add(a, b, c) {
  return a + b + c;
}

const curriedAdd = curry(add);

console.log(curriedAdd(1)(2)(3)); // 6
console.log(curriedAdd(1, 2)(3)); // 6
console.log(curriedAdd(1)(2, 3)); // 6
三、常见误区或面试陷阱
- 将柯里化错误理解为只能一层传一个参数,实际上可支持多参数逐层传递
- 忽视函数的
.length属性,它表示函数的声明参数数量,不是调用时传入参数数量 - 不清楚闭包在柯里化中的作用,容易出错在参数收集和函数返回上
- 不能应用于可变参数函数(rest 参数)时,未区分普通函数与变参函数的实现难点
5. 说明如何通过BOM获取浏览器窗口的尺寸
题目要点
- 使用
window.innerWidth和window.innerHeight获取视口尺寸 - 兼容性处理:加入
document.documentElement.clientWidth兜底 - 区分视口尺寸、页面尺寸和屏幕尺寸
- 使用
resize事件监听窗口变化 - 理解不同属性在不同浏览器或文档模式下的行为差异
参考答案
考察点
- 掌握 BOM(浏览器对象模型)的基本概念与用途
- 熟悉
window对象与document对象在视口尺寸获取方面的区别 - 能够准确获取当前浏览器窗口的宽度与高度,并能适配多浏览器兼容性
- 能够判断窗口大小变化并响应(如监听 resize 事件)
参考答案
一、原理说明
BOM(Browser Object Model)允许开发者与浏览器窗口进行交互。其中 window 对象提供了访问浏览器窗口视口尺寸的能力。
需要区分:
- 视口尺寸(viewport):浏览器当前可视区域,不包含滚动条等 UI 元素
- 页面尺寸(document size):整个页面的宽高,可能大于视口
- 屏幕尺寸(screen size):设备屏幕的尺寸
二、核心用法 + 示例代码
1. 获取视口宽高(推荐方式):
const width = window.innerWidth;
const height = window.innerHeight;
✅ 含义:返回浏览器可视区域(viewport)的宽高,不包括工具栏/边框。
2. 兼容方式(适配 IE):
const width = window.innerWidth || document.documentElement.clientWidth || document.body.clientWidth;
const height = window.innerHeight || document.documentElement.clientHeight || document.body.clientHeight;
3. 响应窗口大小变化:
window.addEventListener('resize', () => {
  console.log('窗口宽度:', window.innerWidth);
  console.log('窗口高度:', window.innerHeight);
});
三、常见误区或面试陷阱
- ❌ 使用
document.body.clientWidth不适配 IE 和标准模式下的表现差异 - ❌ 将
screen.width与window.innerWidth混淆(前者是整个屏幕尺寸,后者是当前页面视口) - ❌ 忽略
window.innerHeight包含滚动条宽度这一事实,可能导致布局误差 - ❌ 没有监听
resize事件,导致响应式逻辑失效
6. for…in 和 for…of 的区别是什么
题目要点
for...in/ 遍历对象可枚举属性 / 包括原型链 / 返回键名for...of/ 遍历可迭代对象元素 / 返回值 / 常用于数组、Set、Mapfor...in不适合数组遍历 /for...of无法直接遍历对象- 搭配
Object.entries或arr.entries()提高语义性 - 注意
for...in需过滤原型属性 /for...of需迭代协议支持
参考答案
一、考察点
for…in 与 for…of 的核心用途区别
for...in是用来枚举对象的可枚举属性(包括原型链上的)for...of是用来遍历可迭代对象的元素(如数组、字符串、Set、Map 等)
实际使用中这两种遍历的典型场景和边界条件
for...in常用于遍历普通对象的属性,但不建议用于数组for...of适用于需要按顺序访问集合中元素的场景,如数组、字符串、NodeList 等
面试官希望判断的核心能力
- 能否正确选择合适的遍历方式,理解底层机制
- 是否了解两者对原型链、索引顺序、返回值等的处理差异
- 能否识别实际开发中误用造成的问题
二、参考答案
1.1 原理说明
✅ for...in 的定义和工作机制
- 用于遍历对象自身和继承的可枚举属性的键名(字符串)
- 遍历顺序不一定是按照属性定义的顺序
- 常用于处理普通对象属性,但对数组存在顺序不可预期的问题
const obj = { a: 1, b: 2 };
for (let key in obj) {
  console.log(key); // 输出 a, b(顺序不保证)
}
✅ for...of 的定义和工作机制
- 用于遍历可迭代对象(实现了
Symbol.iterator接口的对象) - 直接访问集合中的值(而非键名)
- 支持数组、字符串、Set、Map、DOM NodeList、TypedArray 等
const arr = [10, 20, 30];
for (let value of arr) {
  console.log(value); // 输出 10, 20, 30
}
🔍 两者的根本区别
| 比较项 | for…in | for…of |
|---|---|---|
| 遍历对象 | ✔️ 可用 | ❌ 报错(除非对象实现了 Symbol.iterator) |
| 遍历数组 | ✔️ 不推荐(遍历索引) | ✔️ 推荐(遍历值) |
| 遍历顺序 | 不保证 | 保证迭代顺序 |
| 返回内容 | 键名(字符串) | 元素值 |
| 是否遍历原型链 | ✔️ 是 | ❌ 否 |
| 是否只能遍历可枚举属性 | ✔️ 是 | ❌ 可迭代即行 |
1.2 核心用法 + 示例代码
🎯 在对象属性遍历中使用 for...in
const obj = { name: 'Tom', age: 20 };
for (let key in obj) {
  if (obj.hasOwnProperty(key)) {
    console.log(`${key}: ${obj[key]}`);
  }
}
- 注意使用
hasOwnProperty过滤继承属性 - 通常在处理纯对象(非数组)属性结构时使用
🎯 在数组/集合元素遍历中使用 for...of
const set = new Set(['a', 'b', 'c']);
for (let val of set) {
  console.log(val); // 'a', 'b', 'c'
}
- 遍历值而非索引,语义清晰
- 避免因为索引遍历带来的数组稀疏问题
🎯 用 for...of 结合 entries() 遍历数组索引和值
const arr = ['x', 'y', 'z'];
for (let [index, value] of arr.entries()) {
  console.log(index, value);
}
entries()返回[index, value]的迭代器- 对需要访问数组索引的场景非常有用
1.3 常见误区或面试陷阱
❌ 误区一:使用 for...in 遍历数组
const arr = ['a', 'b', 'c'];
for (let i in arr) {
  console.log(i); // 输出 0, 1, 2 —— 是索引,不是值
}
- 返回的是字符串索引
- 遍历顺序不一定保证(特别是有自定义属性时)
- 若数组存在稀疏项,会将“空洞”也遍历出来
❌ 误区二:误以为 for...of 可以遍历普通对象
const obj = { x: 1, y: 2 };
for (let val of obj) {
  // ❌ TypeError: obj is not iterable
}
- 普通对象默认不是可迭代对象
- 若想遍历对象属性和值,应使用
Object.entries(obj)配合for...of:
for (let [key, value] of Object.entries(obj)) {
  console.log(key, value);
}
❌ 误区三:未区分是否遍历原型属性
for...in会遍历原型链上的属性,不加判断会引入意外行为for...of不会访问原型属性,更安全
7. 在遍历数组时,为什么推荐使用 for…of 而不是 for…in
题目要点
for...in遍历索引(字符串),还会遍历自定义属性和原型链for...of直接遍历元素值,语义清晰,行为可控for...in不保证遍历顺序 /for...of按插入顺序迭代- 推荐数组使用
for...of/ 需要索引时可用arr.entries() - 面试时务必指出
for...in存在原型污染风险,强调可维护性和语义性
参考答案
一、考察点
是否理解
for...in和for...of在数组遍历中的本质差异for...in遍历的是属性名(索引)for...of遍历的是元素值
能否识别数组结构中常见的风险点,如稀疏数组、原型污染、自定义属性等
- 了解
for...in可能访问到非索引属性,遍历顺序不确定
- 了解
是否有实际项目中选择合适遍历方式的经验
- 面试官希望看到你在实践中有意识地区分并选择合适工具,确保语义清晰、行为安全
二、参考答案
1.1 原理说明
✅ for...in 是为对象设计的
for...in会枚举对象的所有可枚举属性,包括从原型链继承而来的属性- 对数组来说,
for...in遍历的是数组的键名(即索引),返回的是字符串形式的索引
const arr = ['a', 'b', 'c'];
for (let i in arr) {
  console.log(typeof i); // "string"
}
✅ for...of 是为可迭代结构设计的
for...of使用数组的[Symbol.iterator]方法,返回数组中的元素值- 语义更清晰,行为更符合“遍历数组元素”的直觉
const arr = ['a', 'b', 'c'];
for (let val of arr) {
  console.log(val); // "a", "b", "c"
}
1.2 核心用法 + 示例代码
🎯 for...in 的问题:遍历顺序不可控 + 原型链属性污染 + 类型非数字
Array.prototype.extra = 'polluted';

const arr = ['x', 'y'];
arr.custom = 'meta';

for (let i in arr) {
  console.log(i); // "0", "1", "custom", "extra"
}
- 不仅遍历数组索引,还遍历自定义属性和原型属性
- 返回的索引是字符串类型(需额外转换)
✅ for...of 的推荐方式:语义更清晰、只遍历数组值
const arr = ['x', 'y'];
arr.custom = 'meta';

for (let val of arr) {
  console.log(val); // "x", "y"
}
- 忽略自定义属性和原型链
- 简洁直接,行为符合预期
✅ 如果需要索引 + 值,搭配 arr.entries() 更合理
for (let [index, value] of arr.entries()) {
  console.log(index, value);
}
entries()提供[索引, 值]的迭代器- 与
Object.entries(obj)一致,便于统一理解
1.3 常见误区或面试陷阱
❌ 误区一:误以为 for...in 和 for...of 效果一致
实际上:
for...in遍历的是属性名(可能包括非数组内容)for...of遍历的是元素值(严格只对可迭代结构)
❌ 误区二:忽视原型链污染带来的问题
Array.prototype.extra = 123;
const arr = ['a', 'b'];
for (let i in arr) {
  console.log(i); // "0", "1", "extra"
}
- 非常容易造成代码逻辑异常
❌ 误区三:误用 for...of 遍历普通对象
const obj = { a: 1, b: 2 };
for (let val of obj) {
  // ❌ TypeError: obj is not iterable
}
for...of仅适用于实现了迭代器接口的结构(数组、Set、Map、字符串、类数组)
8. 哪些地方不能使用箭头函数
题目要点
- 箭头函数无自身
this,继承外层上下文 - 不能作为构造函数使用,无法用
new - 对象方法中如果需要
this指向自身,不应使用箭头函数 - 事件处理函数依赖
this时不适合箭头函数 - 箭头函数无
arguments,用剩余参数代替 - 不支持
prototype,不能绑定this
参考答案
一、考察点
箭头函数的设计初衷及其与普通函数的区别
- 了解箭头函数的核心特性:没有自己的
this、arguments、super和new.target
- 了解箭头函数的核心特性:没有自己的
能够识别适合与不适合使用箭头函数的具体场景
- 能否结合项目需求正确选择函数定义方式,避免运行时错误
理解箭头函数在构造函数、事件绑定、对象方法中的限制
- 知道不同调用场景下
this绑定差异,避免错误引用
- 知道不同调用场景下
二、参考答案
1.1 原理说明
✅ 箭头函数的核心特点
- 箭头函数没有自己的
this,它的this是继承自外层最近的非箭头函数的this - 没有自己的
arguments对象,使用时会访问外层函数的arguments - 不能用作构造函数,无法使用
new关键字实例化 - 没有
prototype属性 - 不能绑定
this,即call、apply、bind不会改变箭头函数的this
🔍 这导致了箭头函数在以下场景中不适用或容易出错
1.2 核心用法 + 示例代码
🚫 不能作为构造函数使用
const Foo = () => {};
const obj = new Foo(); // TypeError: Foo is not a constructor
- 普通函数可用作构造函数
- 箭头函数没有
prototype,无法实例化
🚫 不能用作对象的方法(若依赖 this 指向调用对象)
const obj = {
  value: 42,
  getValue: () => {
    return this.value;
  }
};
console.log(obj.getValue()); // undefined,this指向外层上下文(通常是window/global)
- 这里
this并非指向obj - 如果需要方法内部访问对象本身,应使用普通函数或简写方法
const obj = {
  value: 42,
  getValue() {
    return this.value;
  }
};
console.log(obj.getValue()); // 42
🚫 不适合用作事件处理函数(尤其是依赖事件绑定的 this)
button.addEventListener('click', () => {
  console.log(this); // this指向定义时的外层作用域,而非按钮元素
});
- 传统函数中的
this指向事件源(DOM元素) - 箭头函数继承了外层
this,失去了事件绑定的语义
🚫 不能使用 arguments 对象
const fn = () => {
  console.log(arguments); // ReferenceError: arguments is not defined
};
fn(1, 2, 3);
- 箭头函数没有自己的
arguments,若需使用参数列表,可以用剩余参数...args
const fn = (...args) => {
  console.log(args);
};
1.3 常见误区或面试陷阱
❌ 误区一:误用箭头函数作为类的方法或构造器
- 以为箭头函数写法可以代替类方法,导致无法访问实例属性或产生意外的
this
❌ 误区二:错误绑定事件监听中的 this
- 使用箭头函数作为事件回调,
this不指向事件元素,引发代码逻辑异常
❌ 误区三:依赖 arguments 的函数误用箭头函数
- 代码中仍旧直接用
arguments,导致错误或不符合预期
9. 创建一个对象的过程有哪些方式
题目要点
- 对象字面量:简单,快速,原型是
Object.prototype - 构造函数 +
new:创建实例,支持继承 - 工厂函数:灵活,返回新对象,不支持继承
Object.create(proto):指定原型,原型式继承- ES6 类:语法糖,面向对象语法,继承基于原型链
- 区分使用场景,理解原型链及内存效率
参考答案
一、考察点
了解 JavaScript 中创建对象的多种方式及其底层原理
- 能够区分字面量、构造函数、工厂函数、类、
Object.create等方法
- 能够区分字面量、构造函数、工厂函数、类、
掌握每种创建方式的优缺点及适用场景
- 包括内存使用、继承机制、属性和方法定义等方面
理解原型链与继承关系在对象创建中的体现
- 认识
prototype的作用和对象之间的联系
- 认识
能够根据需求灵活选择创建对象的方式
二、参考答案
1.1 原理说明
✅ 1. 对象字面量
- 直接使用
{}创建对象 - 该对象的原型是
Object.prototype - 语法简单,性能优良,适合快速创建单个对象
const obj = { name: 'Tom', age: 20 };
✅ 2. 构造函数(函数 + new)
通过定义构造函数,使用
new关键字实例化对象new操作符执行步骤:- 创建一个新空对象
- 将新对象的
__proto__指向构造函数的prototype - 执行构造函数内部代码,
this指向新对象 - 如果构造函数没有返回对象,则返回新对象
function Person(name, age) {
  this.name = name;
  this.age = age;
}
const p = new Person('Tom', 20);
✅ 3. 工厂函数
- 普通函数返回一个新对象
- 不依赖
new,灵活且易于理解 - 但无法实现对象间的继承关系(除非手动设置)
function createPerson(name, age) {
  return {
    name,
    age
  };
}
const p = createPerson('Tom', 20);
✅ 4. Object.create(proto)
- 通过指定原型对象
proto创建新对象 - 新对象直接继承
proto - 常用于实现原型式继承
const proto = { greet() { console.log('Hello'); } };
const obj = Object.create(proto);
obj.greet(); // Hello
✅ 5. ES6 类(Class)
- 语法糖,底层仍基于原型继承
- 更接近传统面向对象的语法,代码结构清晰
- 类内部的构造函数使用
constructor定义
class Person {
  constructor(name, age) {
    this.name = name;
    this.age = age;
  }
  greet() {
    console.log('Hi, ' + this.name);
  }
}
const p = new Person('Tom', 20);
1.2 核心用法 + 示例代码
| 方式 | 代码示例 | 说明 |
|---|---|---|
| 对象字面量 | const obj = { a: 1 }; | 快速创建,无继承复杂度 |
| 构造函数 | function A() { this.x = 10; } new A(); | 支持原型链,使用广泛 |
| 工厂函数 | function f() { return {x: 10}; } f(); | 简单,灵活,不支持继承 |
| Object.create | const o = Object.create(proto); | 直接指定原型 |
| ES6 类 | class C { constructor() {} } new C(); | 语法简洁,支持继承和静态方法 |
1.3 常见误区或面试陷阱
❌ 误区一:混淆工厂函数和构造函数的区别
- 工厂函数不支持
instanceof判断 - 构造函数需配合
new使用,否则this指向全局(严格模式下为undefined)
❌ 误区二:忽略 Object.create 与构造函数创建的原型链差异
Object.create(null)创建的对象没有原型,无法使用toString等方法
❌ 误区三:误以为 ES6 类是新的继承机制
- 实际是基于原型链的语法糖,底层仍是构造函数和原型链机制
10. 什么是防抖和节流,以及如何编码实现?
题库原题:什么是防抖和节流,以及如何编码实现?
题目要点
本质上是优化高频率执行代码的一种手段
参考答案
一、是什么
本质上是优化高频率执行代码的一种手段
如:浏览器的 resize、scroll、keypress、mousemove 等事件在触发时,会不断地调用绑定在事件上的回调函数,极大地浪费资源,降低前端性能
为了优化体验,需要对这类事件进行调用次数的限制,对此我们就可以采用throttle(节流)和debounce(防抖)的方式来减少调用频率
定义
- 节流: n 秒内只运行一次,若在 n 秒内重复触发,只有一次生效
- 防抖: n 秒后在执行该事件,若在 n 秒内被重复触发,则重新计时
一个经典的比喻:
想象每天上班大厦底下的电梯。把电梯完成一次运送,类比为一次函数的执行和响应
假设电梯有两种运行策略 debounce 和 throttle,超时设定为15秒,不考虑容量限制
电梯第一个人进来后,15秒后准时运送一次,这是节流
电梯第一个人进来后,等待15秒。如果过程中又有人进来,15秒等待重新计时,直到15秒后开始运送,这是防抖
代码实现
节流
完成节流可以使用时间戳与定时器的写法
使用时间戳写法,事件会立即执行,停止触发后没有办法再次执行
function throttled1(fn, delay = 500) {
    let oldtime = Date.now()
    return function (...args) {
        let newtime = Date.now()
        if (newtime - oldtime >= delay) {
            fn.apply(null, args)
            oldtime = Date.now()
        }
    }
}
使用定时器写法,delay毫秒后第一次执行,第二次事件停止触发后依然会再一次执行
function throttled2(fn, delay = 500) {
    let timer = null
    return function (...args) {
        if (!timer) {
            timer = setTimeout(() => {
                fn.apply(this, args)
                timer = null
            }, delay);
        }
    }
}
可以将时间戳写法的特性与定时器写法的特性相结合,实现一个更加精确的节流。实现如下
function throttled(fn, delay) {
    let timer = null
    let starttime = Date.now()
    return function () {
        let curTime = Date.now() // 当前时间
        let remaining = delay - (curTime - starttime)  // 从上一次到现在,还剩下多少多余时间
        let context = this
        let args = arguments
        clearTimeout(timer)
        if (remaining <= 0) {
            fn.apply(context, args)
            starttime = Date.now()
        } else {
            timer = setTimeout(fn, remaining);
        }
    }
}
防抖
简单版本的实现
function debounce(func, wait) {
    let timeout;

    return function () {
        let context = this; // 保存this指向
        let args = arguments; // 拿到event对象

        clearTimeout(timeout)
        timeout = setTimeout(function(){
            func.apply(context, args)
        }, wait);
    }
}
防抖如果需要立即执行,可加入第三个参数用于判断,实现如下:
function debounce(func, wait, immediate) {

    let timeout;

    return function () {
        let context = this;
        let args = arguments;

        if (timeout) clearTimeout(timeout); // timeout 不为null
        if (immediate) {
            let callNow = !timeout; // 第一次会立即执行,以后只有事件执行后才会再次触发
            timeout = setTimeout(function () {
                timeout = null;
            }, wait)
            if (callNow) {
                func.apply(context, args)
            }
        }
        else {
            timeout = setTimeout(function () {
                func.apply(context, args)
            }, wait);
        }
    }
}
二、区别
相同点:
- 都可以通过使用
setTimeout实现 - 目的都是,降低回调执行频率。节省计算资源
不同点:
- 函数防抖,在一段连续操作结束后,处理回调,利用
clearTimeout和setTimeout实现。函数节流,在一段连续操作中,每一段时间只执行一次,频率较高的事件中使用来提高性能 - 函数防抖关注一定时间连续触发的事件,只在最后执行一次,而函数节流一段时间内只执行一次
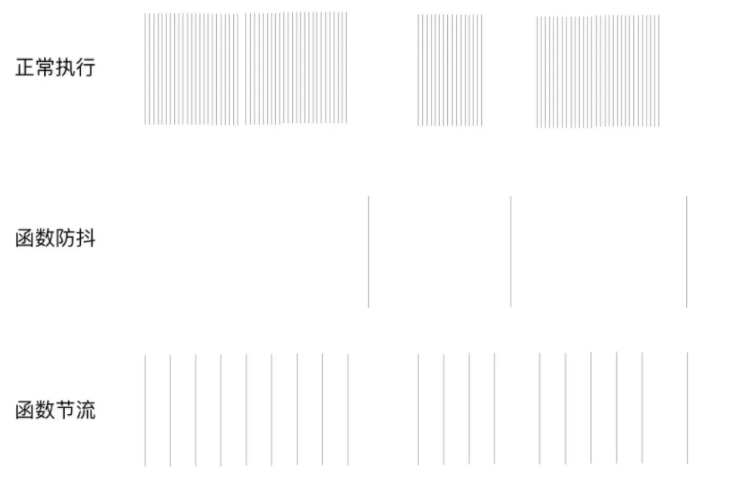
例如,都设置时间频率为500ms,在2秒时间内,频繁触发函数,节流,每隔 500ms 就执行一次。防抖,则不管调动多少次方法,在2s后,只会执行一次
如下图所示:
三、应用场景
防抖在连续的事件,只需触发一次回调的场景有:
- 搜索框搜索输入。只需用户最后一次输入完,再发送请求
- 手机号、邮箱验证输入检测
- 窗口大小
resize。只需窗口调整完成后,计算窗口大小。防止重复渲染。
节流在间隔一段时间执行一次回调的场景有:
- 滚动加载,加载更多或滚到底部监听
- 搜索框,搜索联想功能
11. 在浏览器里,如何自定义一个事件
题目要点
- 使用
new CustomEvent(eventName, { detail, bubbles, cancelable })创建事件 - 使用
element.addEventListener监听,element.dispatchEvent派发 detail用于携带自定义数据- 需根据需求设置
bubbles和cancelable Event不支持携带数据,需用CustomEvent- 事件传播遵循 DOM 事件模型,派发节点及其祖先能接收到事件
参考答案
一、考察点
掌握浏览器事件模型及自定义事件的实现原理
- 理解事件的类型(原生事件、自定义事件)
- 理解事件的派发(dispatch)和监听机制
熟悉 CustomEvent API 的使用方法
- 能够创建和初始化自定义事件,携带数据
- 理解事件的冒泡、取消默认行为等配置项
能够合理使用自定义事件解决组件间通信或解耦需求
二、参考答案
1.1 原理说明
- 浏览器的事件系统支持自定义事件,允许开发者创建并派发非标准的事件类型
- 自定义事件基于
Event或更常用的CustomEvent构造函数 CustomEvent允许传递附加信息(detail),增强事件表达能力- 事件的传播(捕获、冒泡)机制依然适用,开发者可控制事件是否冒泡和是否可取消
1.2 核心用法 + 示例代码
🎯 创建并派发自定义事件
// 1. 创建自定义事件,携带数据
const myEvent = new CustomEvent('my-event', {
  detail: { message: 'Hello, custom event!' },
  bubbles: true,      // 事件是否冒泡
  cancelable: true    // 事件是否可取消默认行为
});

// 2. 监听该事件
document.addEventListener('my-event', (e) => {
  console.log('Received:', e.detail.message);
});

// 3. 派发事件
document.dispatchEvent(myEvent);
new CustomEvent(eventType, eventInit):创建事件,eventInit可配置detail、bubbles、cancelable- 使用
addEventListener监听,使用dispatchEvent派发 - 事件可以冒泡,便于组件间层级传播
🎯 自定义事件在组件通信中的典型应用
- 当子组件需通知父组件某事件发生时,可使用自定义事件
- 适合解耦、无须借助全局状态管理的简单场景
// 子元素触发
const child = document.querySelector('#child');
const event = new CustomEvent('child-action', { detail: { data: 123 }, bubbles: true });
child.dispatchEvent(event);

// 父元素监听
const parent = document.querySelector('#parent');
parent.addEventListener('child-action', (e) => {
  console.log('Child triggered with data:', e.detail.data);
});
1.3 常见误区或面试陷阱
❌ 误区一:使用 new Event() 代替 CustomEvent() 传递数据
Event构造函数不能携带detail数据,不能传递额外信息- 需用
CustomEvent来携带自定义数据
❌ 误区二:忽略事件是否冒泡和取消默认行为配置
- 自定义事件默认不冒泡,需显式设置
bubbles: true才能向上层节点传播 - 取消默认行为相关设置通常用于表单事件,普通自定义事件较少用到
❌ 误区三:错误理解事件派发范围
dispatchEvent派发事件只能在绑定的 DOM 节点及其祖先节点中捕获,不能跨 DOM 树传播
12. 如何获取页面中出现最多的元素
题目要点
- 遍历 DOM 树,递归或使用
getElementsByTagName('*') - 统计元素标签出现次数,使用对象或 Map 保存计数
- 返回出现次数最多的标签及次数
- 过滤非元素节点(
nodeType === 1) - 标签名统一大小写处理
参考答案
一、考察点
理解 DOM 树结构及遍历方法
- 熟悉如何访问和遍历页面所有元素节点
掌握统计元素出现频率的思路
- 通过对象或 Map 统计元素标签名的出现次数
能够编写高效且兼容的代码遍历和计算结果
- 理解性能优化与避免重复计算的技巧
二、参考答案
1.1 原理说明
- 页面中的元素组成了 DOM 树,通过遍历整个树,可以访问每个元素节点
- 利用深度优先或广度优先遍历 DOM 树
- 在遍历过程中,统计每个元素的标签名称出现次数
- 统计完成后,找出出现次数最高的元素标签及其数量
- 该问题考察对 DOM 操作、数据结构(计数映射)、遍历算法的理解
1.2 核心用法 + 示例代码
🎯 通过递归深度优先遍历统计元素出现次数
function getMostFrequentElementTag(root = document.body) {
  const counts = new Map();

  function traverse(node) {
    if (node.nodeType === 1) { // 元素节点
      const tag = node.tagName.toLowerCase();
      counts.set(tag, (counts.get(tag) || 0) + 1);
      for (let child of node.children) {
        traverse(child);
      }
    }
  }

  traverse(root);

  let maxTag = null;
  let maxCount = 0;
  for (const [tag, count] of counts.entries()) {
    if (count > maxCount) {
      maxTag = tag;
      maxCount = count;
    }
  }

  return { tag: maxTag, count: maxCount };
}

// 使用示例
const result = getMostFrequentElementTag();
console.log(`页面中出现最多的元素是 <${result.tag}>,共出现 ${result.count} 次`);
🎯 代码说明
- 使用递归函数
traverse遍历所有元素节点 - 用
Map记录标签出现次数 - 遍历完成后找出最大值对应的标签
- 返回标签和次数结果
1.3 常见误区或面试陷阱
❌ 误区一:仅统计 document.getElementsByTagName('*') 而不递归
document.getElementsByTagName('*')可一次性获得所有元素节点,但遍历整个树更灵活- 直接用此方法性能一般足够,但递归更能展示对 DOM 树结构理解
❌ 误区二:未区分元素节点和其他节点类型
- 需判断
nodeType === 1确保只统计元素节点,避免统计文本节点、注释节点等
❌ 误区三:大小写不统一导致标签名重复计数
- 标签名统一转小写,避免
<DIV>和<div>被当作不同标签
13. 如果页面元素数量非常大,如何优化这个过程(获取页面中出现最多的元素)
题目要点
- 优先使用
document.getElementsByTagName('*')批量获取元素,避免递归 - 遍历时缓存并统一标签名大小写,减少重复操作
- 对大规模元素,采用异步分批处理(
requestIdleCallback/setTimeout) - 使用高效数据结构(如
Map)统计出现次数 - 避免主线程长时间阻塞,保障页面流畅体验
参考答案
一、考察点
理解大规模 DOM 遍历的性能瓶颈
- 识别遍历大量节点时 CPU 和内存的消耗问题
掌握前端性能优化思路和技巧
- 减少遍历次数,避免重复计算
- 利用浏览器原生 API 优化遍历效率
- 采用异步处理避免阻塞主线程
熟悉合理的数据结构使用
- 高效的计数和查找策略
二、参考答案
1.1 原理说明
遍历庞大 DOM 树时,直接递归或多次访问 DOM 可能导致性能瓶颈,阻塞渲染和交互
优化方向包括:
- 减少 DOM 访问次数:DOM 操作代价高,减少访问频率可提升性能
- 使用浏览器优化的 API:例如
document.getElementsByTagName('*')一次性批量获取元素 - 批处理与异步分片:用
requestIdleCallback或setTimeout分批遍历,避免主线程长时间阻塞 - 避免不必要的计算和转换:统一标签大小写、避免重复转换
使用高效的数据结构(如
Map)快速统计和查找最大值
1.2 核心用法 + 示例代码
🎯 使用 document.getElementsByTagName('*') 批量获取所有元素,避免递归
function getMostFrequentTagOptimized() {
  const counts = new Map();
  const elements = document.getElementsByTagName('*');

  // 直接遍历HTMLCollection,性能高于递归访问
  for (let i = 0; i < elements.length; i++) {
    const tag = elements[i].tagName.toLowerCase();
    counts.set(tag, (counts.get(tag) || 0) + 1);
  }

  let maxTag = null;
  let maxCount = 0;
  for (const [tag, count] of counts.entries()) {
    if (count > maxCount) {
      maxTag = tag;
      maxCount = count;
    }
  }

  return { tag: maxTag, count: maxCount };
}
🎯 分批异步处理避免阻塞(大规模元素时)
function getMostFrequentTagAsync(callback) {
  const counts = new Map();
  const elements = document.getElementsByTagName('*');
  const batchSize = 1000;
  let index = 0;

  function processBatch() {
    const end = Math.min(index + batchSize, elements.length);
    for (; index < end; index++) {
      const tag = elements[index].tagName.toLowerCase();
      counts.set(tag, (counts.get(tag) || 0) + 1);
    }
    if (index < elements.length) {
      // 利用 requestIdleCallback 优先闲置时执行,兼容性差时用 setTimeout 替代
      if (window.requestIdleCallback) {
        requestIdleCallback(processBatch);
      } else {
        setTimeout(processBatch, 0);
      }
    } else {
      // 处理完成,找最大值
      let maxTag = null;
      let maxCount = 0;
      for (const [tag, count] of counts.entries()) {
        if (count > maxCount) {
          maxTag = tag;
          maxCount = count;
        }
      }
      callback({ tag: maxTag, count: maxCount });
    }
  }

  processBatch();
}

// 使用示例
getMostFrequentTagAsync(result => {
  console.log(`出现最多的元素是 <${result.tag}>,数量为 ${result.count}`);
});
1.3 常见误区或面试陷阱
❌ 误区一:直接递归遍历大 DOM,导致页面卡顿甚至假死
- 深度优先递归在节点非常多时,主线程长时间被占用,影响用户体验
❌ 误区二:频繁访问和操作 DOM 属性
- 例如在循环内多次调用
tagName但不缓存,增加性能开销
❌ 误区三:不考虑异步分片或任务调度
- 长时间同步操作阻塞 UI,导致浏览器无法响应用户输入
14. 简单介绍下React中的 diff 算法
题库原题:简单介绍下React中的 diff 算法
题目要点
React 的 diff 算法用于高效地更新虚拟 DOM 和实际 DOM 的过程。它的主要目标是最小化对实际 DOM 的操作,从而提高性能。以下是简单介绍:
Diff 算法概述
虚拟 DOM 树比较:
- 比较:React 使用虚拟 DOM 树来表示组件的当前状态。每当组件的状态或属性发生变化时,React 会创建一个新的虚拟 DOM 树并将其与旧的虚拟 DOM 树进行比较。
- 目标:通过比较旧的虚拟 DOM 树和新的虚拟 DOM 树,找出需要更新的部分。
算法原理:
- 树的层级比较:React diff 算法采用逐层比较的策略。它只比较同一层级的节点,而不是整个树。这样可以提高性能,避免不必要的计算。
- 同层级节点比较:在同一层级上,React 通过比较节点的类型和属性来判断节点是否发生变化。如果节点类型相同,React 会进一步比较属性和子节点。
优化策略:
- 唯一 Key 属性:对于列表中的元素,React 使用
key属性来标识每个元素,帮助算法识别和匹配元素,避免重新渲染整个列表。 - 组件更新:对于函数组件和类组件,React 会根据组件的
render方法返回的新虚拟 DOM 和之前的虚拟 DOM 进行比较,只有在有必要时才会更新实际 DOM。
- 唯一 Key 属性:对于列表中的元素,React 使用
更新策略:
- 局部更新:通过比较,React 能够精确地确定哪些部分需要更新,只对这些部分进行实际 DOM 更新,从而减少性能开销。
- 重用节点:在可能的情况下,React 会重用现有的 DOM 节点,减少不必要的 DOM 操作。
总结
React 的 diff 算法通过对虚拟 DOM 树的逐层比较和局部更新策略,能够高效地更新实际 DOM,减少性能开销。使用唯一的 key 属性和优化的节点比较机制,使得算法能够快速识别变化并进行最小化的 DOM 更新。
参考答案
diff 算法主要基于三个规律:
- DOM 节点的跨层级移动的操作特别少,可以忽略不计
- 拥有相同类的两个组件将会生成相似的树形结构,拥有不同类的两个组件将会生成不同的树形结构
- 对于同一层级的一组子节点,可以通过唯一的 id 进行区分
tree diff
因为上面的三个策略中的第一点, DOM 节点的跨级操作比较少,那么 diff 算法只会对相同层级的 DOM 节点进行比较。如果发现节点不存在 那么会将该节点以及其子节点完全删除,不会再继续比较。如果出现了 DOM 节点的跨层级的移动操作,那么会删除改节点以及其所有的子节点,然后再移动后的位置重新创建。
component diff
如果是同一类型的组件,那么会继续对比 VM 数
如果不是同一类型的组件,那么会将其和其子节点完全替换,不会再进行比对
同一类型的组件,有可能 VM 没有任何的变化,如果可以确定的知道这点,那么就可以节省大量的 diff 时间,所以用户可以设置 shouldComponentUpdate() 来判断是否需要进行 diff 算法。
element diff
当节点处于同一层级的时候时,有三种操作:INSERT_MAKEUP插入、 MOVE_EXISTING 移动、 REMOVE_NODE 删除
这里 React 有一个优化策略,对于同一层级的同组子节点,添加唯一的 key 进行区分。这样的话,就可以判断出来是否是移动节点。通过 key 发现新旧集合中的节点都是相同的节点,就只需要进行移动操作就可以。
15. 有看过Redux的源码吗
题目要点
- Redux 以单一状态树和纯函数 reducer 管理状态
createStore实现状态存储、分发与订阅combineReducers实现状态模块化管理- 源码简洁,关注状态不可变性和可预测性
- 理解订阅和通知机制,防止内存泄漏
参考答案
一、考察点
了解 Redux 源码设计的核心思想和架构
- 掌握 Redux 的状态管理机制、单一状态树和不可变数据原则
理解 Redux 的核心 API 实现原理
createStore、dispatch、subscribe、combineReducers等方法的工作机制
具备阅读和分析大型开源项目源码的能力
- 能从源码中理解设计模式和代码实现细节
面试官希望确认候选人是否具备扎实的前端状态管理理论和实践基础
二、参考答案
1.1 原理说明
Redux 核心设计理念
- 单一状态树:应用的所有状态保存在一个对象树中,方便管理和调试
- 不可变状态:通过纯函数(reducer)返回新的状态,保证状态不可变
- 动作(Action)描述“发生了什么”:通过分发 Action 来改变状态,保证可预测性
- 纯函数 Reducer:根据旧状态和 Action 返回新状态,没有副作用
Redux 核心模块和关系
createStore创建状态管理仓库,包含状态和相关操作dispatch发送 Action,触发 Reducer 生成新状态subscribe监听状态变化,实现响应式更新combineReducers将多个 reducer 合并为一个总 reducer,实现状态模块化
1.2 核心用法 + 示例代码(源码关键片段解析)
createStore 关键逻辑简析
function createStore(reducer, preloadedState, enhancer) {
  let currentState = preloadedState;
  let currentListeners = [];

  function getState() {
    return currentState;
  }

  function subscribe(listener) {
    currentListeners.push(listener);
    return function unsubscribe() {
      const index = currentListeners.indexOf(listener);
      currentListeners.splice(index, 1);
    }
  }

  function dispatch(action) {
    currentState = reducer(currentState, action);
    currentListeners.forEach(listener => listener());
    return action;
  }

  // 初始化 state
  dispatch({ type: '@@redux/INIT' });

  return { getState, dispatch, subscribe };
}
- 核心流程:调用
dispatch传入 Action,Reducer 返回新状态,通知订阅者 - 订阅机制:监听者模式实现状态变化广播
- 初始化时发送特殊 Action,保证 state 有初始值
combineReducers 实现要点
- 将多个 slice reducer 按状态键名组合为一个大 reducer
- 每个子 reducer 独立维护自己对应状态片段,保证职责单一
function combineReducers(reducers) {
  return function combination(state = {}, action) {
    const nextState = {};
    for (let key in reducers) {
      nextState[key] = reducers[key](state[key], action);
    }
    return nextState;
  }
}
1.3 常见误区或面试陷阱
❌ 误区一:认为 Redux 是框架,必须全局使用
- Redux 是状态管理库,使用与否取决于应用需求
❌ 误区二:不理解不可变状态,直接修改 state
- 违反 Redux 设计原则,导致状态不可追踪和不可预测
❌ 误区三:不理解订阅机制,误用 subscribe 导致内存泄漏
- 未正确取消订阅或多次重复订阅
16. Redux中 combineReducers 的实现原理
题目要点
combineReducers输入多个 slice reducer,输出根 reducer- 根 reducer 调用每个子 reducer,分别计算子状态
- 返回新状态对象,且只在子状态改变时才更新
- 内部检查防止 reducer 返回
undefined - 实现状态模块化和性能优化的核心手段
参考答案
一、考察点
理解 Redux 状态拆分和管理的设计思想
- 如何将多个 reducer 组合成一个整体 reducer,支持状态模块化
掌握
combineReducers的源码实现机制- 输入参数、状态传递、错误处理、性能优化等
理解函数式编程中 reducer 的组合思想
- reducer 的纯函数特性与组合逻辑
能够准确描述
combineReducers处理状态切片和动作的细节
二、参考答案
1.1 原理说明
Redux 状态模块化管理需求
- Redux 应用的状态通常拆分为多个子状态(slice)
- 每个子状态由一个 reducer 管理
- 需要将多个 slice reducer 合成一个根 reducer,整体管理状态树
combineReducers 核心思想
- 输入:一个包含若干 slice reducer 的对象(key 是状态字段名,value 是对应 reducer)
- 输出:一个新的 reducer 函数,该函数调用每个子 reducer,生成对应子状态的新值,组合成完整状态对象
- 保证对每个子状态的更新是隔离的、纯粹的
- 保证整体状态对象结构与传入的 reducer 对象结构对应
1.2 核心用法 + 示例代码(简化版核心逻辑)
function combineReducers(reducers) {
  const reducerKeys = Object.keys(reducers);

  return function combination(state = {}, action) {
    const nextState = {};
    let hasChanged = false;

    for (let key of reducerKeys) {
      const reducer = reducers[key];
      const previousStateForKey = state[key];
      const nextStateForKey = reducer(previousStateForKey, action);

      if (typeof nextStateForKey === 'undefined') {
        throw new Error(`Reducer for key "${key}" returned undefined`);
      }

      nextState[key] = nextStateForKey;
      hasChanged = hasChanged || nextStateForKey !== previousStateForKey;
    }

    // 只有当至少有一个子状态发生变化时,才返回新的对象,优化性能
    return hasChanged ? nextState : state;
  };
}
关键细节说明
- 初始化:当传入
undefined的 state,子 reducer 应返回初始状态,保证状态树完整 - 错误检查:如果某个 reducer 返回
undefined,抛出错误,避免隐式错误 - 状态不变检测:用
hasChanged标记是否有子状态更新,避免不必要的状态更新和渲染 - 纯函数组合:合成后的 reducer 依然是纯函数,接受整个状态和动作,返回新的整体状态
1.3 常见误区或面试陷阱
❌ 误区一:忽视子 reducer 返回 undefined 时的错误检查
- 可能导致状态缺失,难以调试
❌ 误区二:直接返回新的对象而不判断是否变化,导致性能浪费
- 每次调用都生成新对象会引起不必要的渲染和更新
❌ 误区三:对传入的 reducers 对象未做有效校验,可能含非法值
- 真实源码中有更多校验逻辑保证安全
17. 在Three.js中,如何对多个模型共享的材质进行优化
题目要点
略
参考答案
略
18. 如果其中一个模型需要修改材质,应该如何处理
题目要点
略
参考答案
略
19. 你用过哪些Three.js的控制器
题目要点
略
参考答案
略
20. 如何使用 OrbitControls 控制相机旋转
题目要点
略
参考答案
略
21. 如何优化点云(Point Cloud)的性能
题目要点
略
参考答案
略
22. 聊聊你的项目经验,主要使用Three.js做了哪些事情
题目要点
略
参考答案
略
23. 项目中遇到的最大技术挑战是什么
题目要点
略
参考答案
略
24. 你是如何解决性能问题的
题目要点
- 定位性能瓶颈(网络、渲染、JS 计算、内存)
- 资源优化:CDN、缓存、懒加载、按需加载
- 渲染优化:减少 DOM 操作,避免重排重绘
- JS 优化:异步调度、高效算法、事件节流防抖
- 内存管理:避免泄漏,合理释放
- 使用工具监控,数据驱动优化
- 针对具体场景,结合多种手段综合优化
参考答案
一、考察点
理解性能瓶颈产生的原因及定位方法
- 能识别前端性能关键点,如渲染、网络、计算等
掌握前端性能优化的多种技术手段
- 包括资源加载优化、代码执行优化、渲染优化等
能够结合具体场景,灵活应用合适的优化策略
- 体现工程实践经验和系统思考能力
展示问题分析、方案设计与验证的完整流程
二、参考答案
1.1 原理说明
性能瓶颈产生的常见原因
- 网络延迟和资源加载慢:大量请求、文件过大、无缓存等
- 渲染阻塞和重绘重排:频繁操作 DOM、复杂样式计算
- JavaScript 计算阻塞:同步执行大量复杂逻辑,阻塞主线程
- 内存泄漏和资源浪费:导致浏览器卡顿或崩溃
- 不合理的数据结构和算法:影响代码执行效率
性能优化的核心目标
- 减少页面首次渲染时间(FCP、TTI)
- 降低主线程负载,保证流畅交互
- 减少网络请求和资源体积
- 优化内存使用,防止泄漏和溢出
1.2 核心做法和策略
资源加载优化
- 使用 CDN 和缓存策略(HTTP 缓存、Service Worker)
- 图片懒加载和压缩,减少资源大小
- 合理拆分和按需加载 JS/CSS(代码分割、动态加载)
- 减少请求数(合并文件、使用雪碧图)
渲染优化
- 减少 DOM 操作,批量更新 DOM(使用虚拟 DOM、DocumentFragment)
- 减少重排和重绘,避免频繁修改样式布局
- 使用 CSS 动画替代 JS 动画,硬件加速
- 优化关键渲染路径,合理使用
will-change和contain
JavaScript 执行优化
- 减少同步阻塞,使用异步/微任务调度(
requestIdleCallback、setTimeout) - 避免频繁创建和销毁对象,减少 GC 压力
- 使用高效算法和数据结构,避免复杂度过高
- 事件节流和防抖,控制频繁事件执行
内存管理
- 避免闭包导致内存泄漏
- 手动解绑事件监听和定时器
- 监控和分析内存使用,及时释放资源
性能监控和调试
- 使用浏览器 DevTools(Performance、Memory、Network 面板)
- 结合 Lighthouse、WebPageTest 等工具分析性能指标
- 通过日志和埋点跟踪实际用户性能数据
1.3 常见误区或面试陷阱
❌ 误区一:盲目追求优化,忽视性能瓶颈定位
- 先定位瓶颈,后针对性优化,避免无效或过度优化
❌ 误区二:只关注某一方面优化,忽略整体体验
- 需兼顾加载速度、渲染性能和交互流畅性
❌ 误区三:忽视用户设备差异
- 针对低端设备做适配优化,保障广泛用户体验